Comment contourner le filigrane SynthID texte ? Limites officielles et réécriture académique
Peut-on supprimer ou contourner le filigrane de texte SynthID ? Analyse des études de DeepMind sur la reformulation, la traduction et la réécriture universitaire.
Depuis l'ouverture internationale du détecteur SynthID le 7 octobre 2026, les requêtes autour de contourner SynthID, supprimer filigrane SynthID ou outil suppression SynthID se multiplient sur le web. Les universitaires, étudiants et professionnels de l'écrit cherchent à comprendre si le filigranage textuel de Google peut être atténué, et comment réagit réellement un texte génératif remanié.
Les réseaux regorgent de conseils erronés, prétendant qu'un simple passage par un traitement de texte brut suffirait. Pour évaluer la réalité technique, il faut se référer aux observations publiées par les chercheurs de Google DeepMind dans leurs publications scientifiques.
Que signifie contourner SynthID pour un texte ?
Dans une photo numérique, un filigrane altère des pixels selon des fréquences invisibles. Dans un texte, il n'y a pas de pixels : SynthID Text fonctionne en appliquant une légère influence statistique sur les probabilités des tokens au fil de la rédaction automatique de Gemini.
Contourner SynthID ne consiste donc pas à supprimer un fichier joint ou un caractère caché. Cela signifie transformer l'ordonnancement des mots de façon à ce que la distribution lexicale ne corresponde plus à la clé de détection secrète de Google avec un seuil statistique probant.
Mythes infondés : copier-coller et balises invisibles
Examinons les astuces populaires qui ne fonctionnent pas :
- Mythe 1 : Coller le texte dans un éditeur brut. L'enregistrement en texte brut enlève le formatage HTML, mais SynthID réside dans le choix des mots réels, non dans les balises.
- Mythe 2 : Supprimer les caractères invisibles de largeur nulle. SynthID n'utilise aucun caractère d'espacement zéro. Le texte est composé exclusivement de caractères typographiques normaux.
- Mythe 3 : Modifier la ponctuation. Ajouter des tirets ou des virgules ne change pas la corrélation statistique globale des tokens choisis.
Données Google DeepMind : que se passe-t-il après des retouches mineures ?
Dans son étude de référence publiée en 2024 dans la revue Nature, Google DeepMind a soumis SynthID Text à des tests de résistance rigoureux :
Lorsqu'un utilisateur supprime des paragraphes entiers, rogne le début du texte ou modifie une poignée de termes, le filigrane conserve sa lisibilité statistique. L'algorithme de détection calculant une moyenne sur une séquence étendue, modifier 5 % ou 10 % des termes est insuffisant pour abaisser le score en deçà du seuil de confiance.
Pourquoi la paraphrase superficielle échoue
Beaucoup pensent qu'un outil de paraphrase grand public résout le problème. Les données de DeepMind indiquent le contraire :
Google souligne expressément que SynthID Text reste détectable après une paraphrase légère. Les outils classiques de réécriture conservent la structure syntaxique d'origine, se contentant d'échanger des substantifs ou des adjectifs par des équivalents proches. L'armature des propositions restant identique, l'empreinte de probabilité demeure visible pour le vérificateur.
Réécriture structurelle et rééchantillonnage de tokens
Où se situe la limite technique documentée par Google ? DeepMind précise que le niveau de confiance de la détection peut être considérablement réduit lorsque le texte fait l'objet d'une réécriture approfondie.
Cette baisse de confiance s'explique par un rééchantillonnage complet des tokens :
- Réorganisation de la syntaxe : inverser l'ordre des propositions subordonnées et principales bouleverse le contexte antérieur régissant le choix des mots.
- Apport d'arguments originaux : rédiger à partir de données de recherche directes au lieu de manipuler une sortie automatique réinitialise l'arbre des probabilités.
- Rupture de la cadence uniforme : alterner des phrases courtes péremptoires et des périodes analytiques denses efface la signature prévisible de l'IA.
La traduction linguistique comme facteur de rupture
Google DeepMind mentionne également la traduction vers une autre langue comme une transformation rompant l'intégrité du signal. Traduire un passage en anglais puis le retraduire en français réécrit le texte selon les probabilités lexicales du moteur de traduction.
Toutefois, la traduction automatique multiple produit des contresens fréquents et brise les références bibliographiques universitaires, ce qui en fait une méthode inadaptée pour des mémoires ou publications scientifiques.
Confiance du filigrane vs détection institutionnelle (Compilatio)
Il ne faut pas confondre le traçage SynthID avec les contrôles d'intégrité universitaires :
Même si un texte réécrit ne présente plus de filigrane SynthID détectable, un détecteur comme Compilatio ou Turnitin peut parfaitement le signaler si sa cadence demeure mécanique et uniforme. Une réécriture efficace doit répondre aux exigences de clarté scientifique et de variation stylistique.
Démarche de réécriture académique responsable et intégrité
Pour un chercheur ou un étudiant de master, l'objectif n'est pas de frauder, mais d'assurer qu'un premier jet aidé par une IA soit converti en un texte scientifique rigoureux et personnel :
- Verrouillez les citations : protégez les mentions d'auteurs et les dates pour éviter toute altération documentaire.
- Conservez les définitions exactes : le vocabulaire technique spécialisé ne doit pas être dénaturé par des synonymes hasardeux.
- Appliquez un rythme vivant : restaurez la perplexité naturelle propre aux travaux de recherche publiés.
Pour approfondir les principes de détection, consultez notre guide complet du détecteur SynthID texte et notre étude sur l'effet de la paraphrase sur SynthID.
Résultats vérifiés face aux détecteurs pour Comment contourner le filigrane SynthID texte ? Limites officielles et réécriture académique
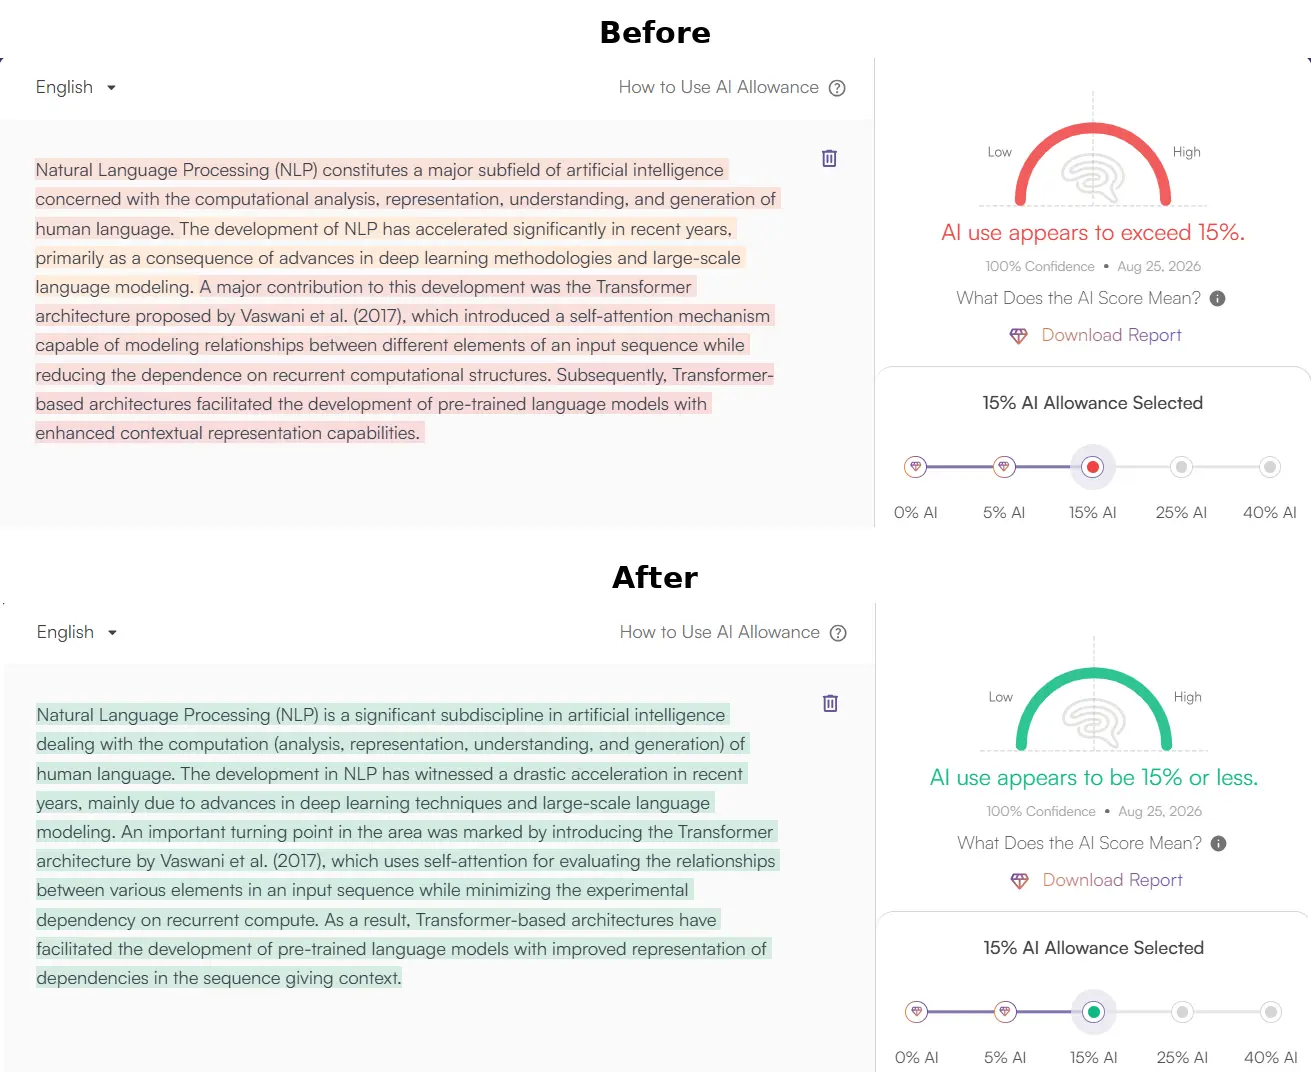
Chaque texte traité avec ThesisHuman s'appuie sur des vérifications reproductibles face aux logiciels d'analyse de texte et aux détecteurs d'IA.
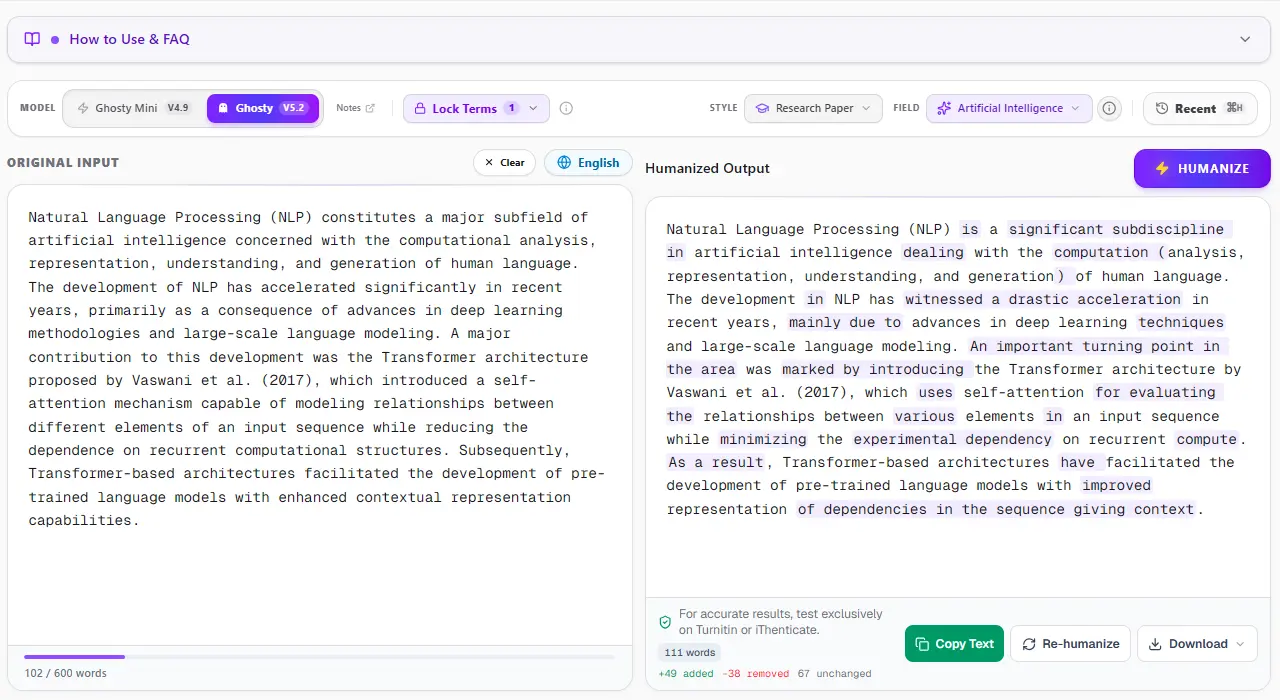
1. Interface ThesisHuman: style, discipline et technologie Term Lock
Contrairement aux paraphraseurs grand public qui remplacent aveuglément les mots par des synonymes approximatifs, ThesisHuman permet de configurer le genre universitaire précis (mémoire de master, thèse de doctorat, article scientifique, revue de littérature) et la discipline concernée (droit, médecine, économie, ingénierie). Grâce à Term Lock, vos citations auteur-date (APA, Harvard), références numériques (Vancouver, IEEE), formules LaTeX et concepts théoriques clés restent rigoureusement intacts pendant le raffinement stylistique.
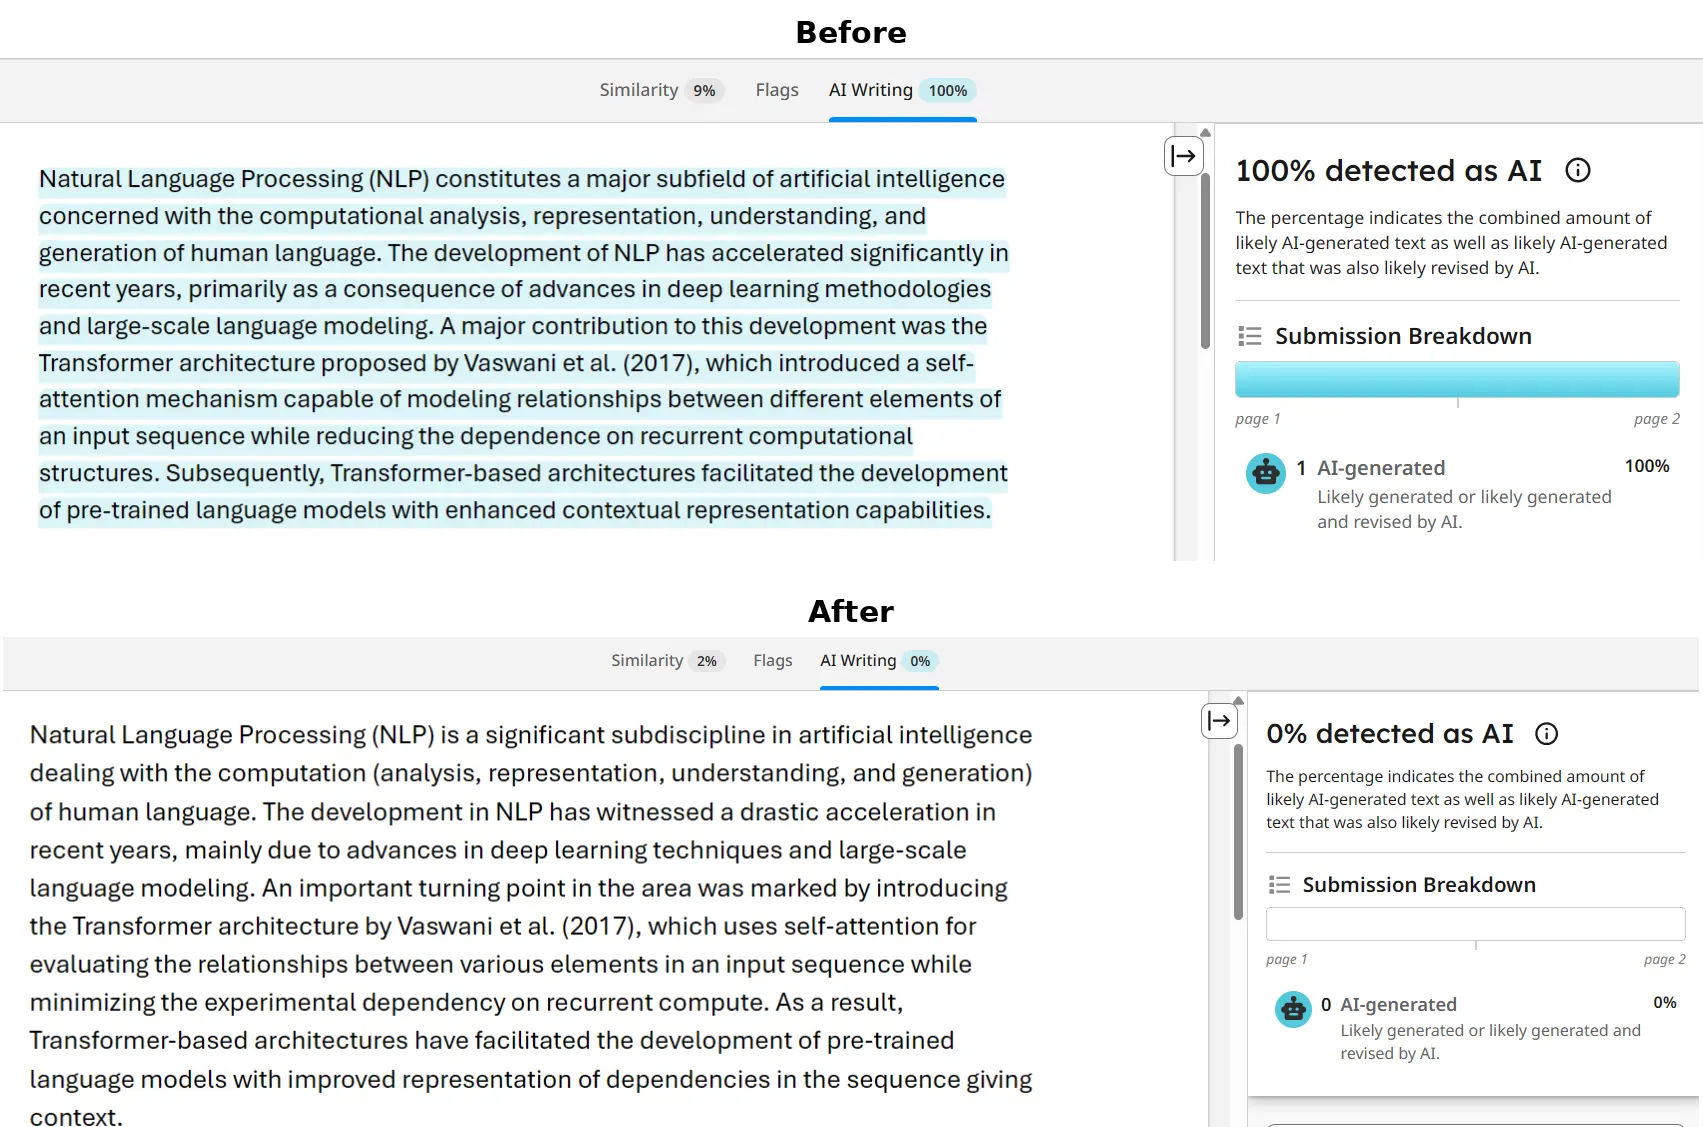
2. Vérification Turnitin et iThenticate: 0% d'indice d'IA
Turnitin et iThenticate examinent les soumissions par segments textuels successifs pour évaluer la régularité mathématique des enchaînements. Un premier jet généré par IA présente une cadence trop prévisible qui alerte les modules de détection. Après passage dans ThesisHuman, la rédaction retrouve l'asymétrie propre à une argumentation personnelle tout en conservant scrupuleusement les références critiques.
3. Vérification GPTZero: conformité des courbes de perplexité et de cadence
GPTZero évalue le texte en mesurant la perplexité des propositions et l'éclatement syntaxique global (burstiness). Les ébauches brutes des modèles présentent une variance faible d'une phrase à l'autre. ThesisHuman rétablit l'asymétrie naturelle de l'écriture intellectuelle en combinant affirmations directes et périodes subordonnées élaborées.
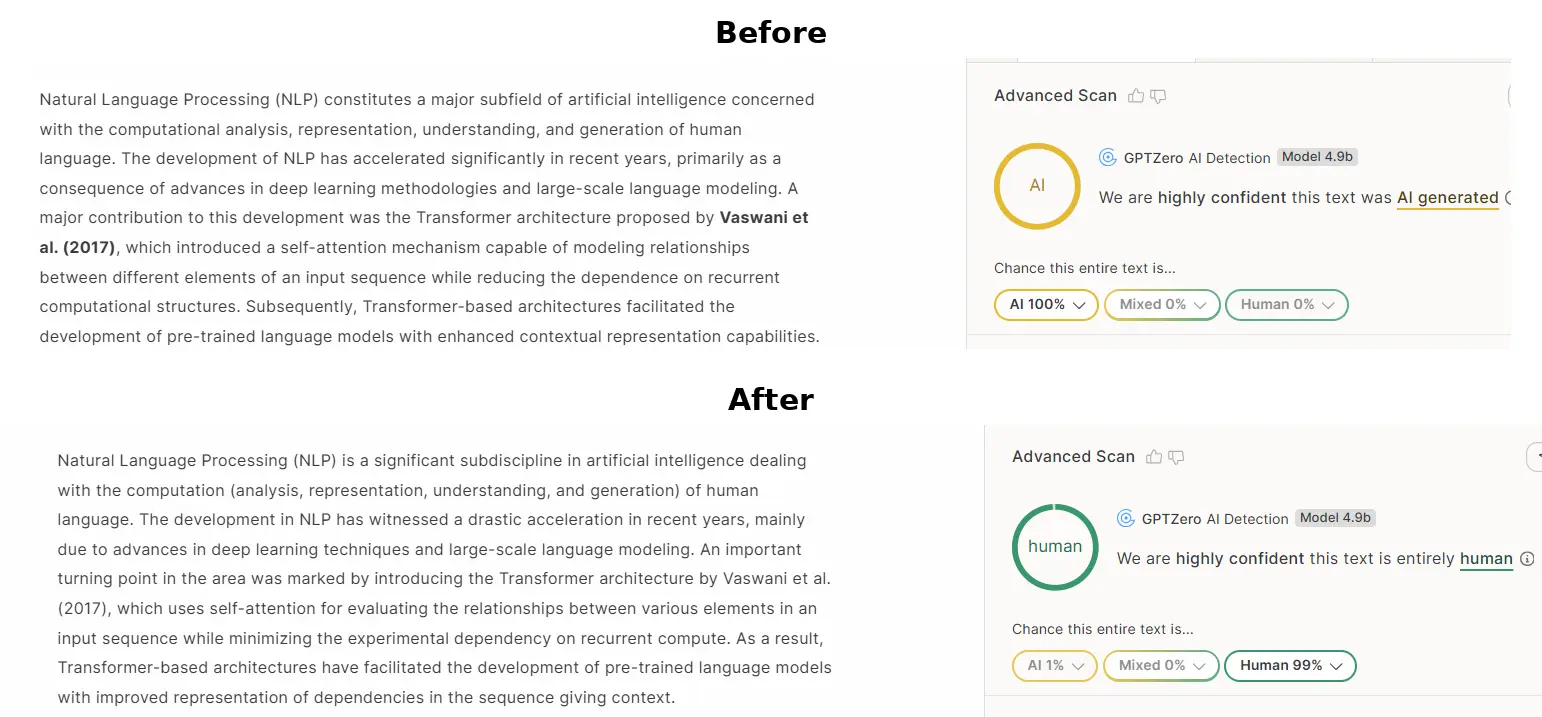
4. Vérification Originality.ai: élimination des n-grammes artificiels
Originality.ai repère les successions prévisibles de n-grammes et les tics de langage récurrents des modèles (tels que 'il convient de souligner', 'un rôle pivot' ou 'témoigne de'). ThesisHuman élimine ces automatismes stylistiques pour renforcer la clarté du propos sans toucher aux équations ni aux citations d'appui.