La paraphrase supprime-t-elle le filigrane SynthID texte ? Réécriture et traduction expliquées
La paraphrase élimine-t-elle le filigrane SynthID ? Découvrez les données de DeepMind comparant synonymes basiques, réécriture structurelle et humanisation.
Avec l'intégration croissante des technologies génératives dans les travaux universitaires, le filigranage textuel est devenu un sujet central de recherche. La méthode SynthID Text de Google DeepMind, qui module imperceptiblement les probabilités des tokens lors de la génération sur Gemini, est le dispositif de traçabilité le plus diffusé. Face à cette innovation, une interrogation pratique revient constamment : la paraphrase supprime-t-elle le filigrane SynthID d'un texte ?
La réponse dépend directement de la nature de la paraphrase. Les données rendues publiques par Google DeepMind mettent en lumière un contraste net : un simple remplacement de synonymes conserve le filigrane, tandis qu'une réécriture structurelle approfondie diminue considérablement la certitude de la détection.
Ce que Google entend par paraphrase légère
Dans ses publications scientifiques dans la revue Nature, Google DeepMind teste la solidité de SynthID Text face à différents degrés de transformation. La paraphrase légère comprend notamment :
- Le remplacement ponctuel de certains mots par des synonymes immédiats.
- L'ajustement mineur de la voix active ou passive sans changer l'ordre des propositions.
- La suppression d'adverbes introductifs superflus.
Dans ces conditions modérées, DeepMind a constaté que le filigrane reste généralement détectable. L'empreinte étant répartie sur des dizaines de transitions lexicales, préserver l'ossature de la phrase permet à la clé de détection de cumuler assez de signaux concordants.
Pourquoi le simple échange de synonymes maintient le signal
La plupart des reformuleurs grand public disponibles en ligne identifient des mots courants pour leur substituer des variantes équivalentes. Par exemple, transformer 'Cette étude démontre un effet significatif' en 'Cette recherche montre un impact notable' change les termes mais laisse intacte l'articulation grammaticale.
SynthID Text appliquant un biais statistique global sur la chaîne de génération, si 80 % de la syntaxe et des transitions de tokens demeurent, la corrélation mathématique avec la clé de Google reste largement au-dessus du seuil de sensibilité.
Réécriture structurelle et rééchantillonnage de probabilités
Le résultat change radicalement lorsque le texte fait l'objet d'un travail de réécriture de fond. Google DeepMind admet que la confiance de détection peut être considérablement réduite par une réécriture approfondie.
La réécriture structurelle implique de repenser l'exposition des idées :
- Fusion et scission de périodes : casser les phrases composées pour créer un rythme asymétrique.
- Reconstruction argumentative : débuter un paragraphe par les preuves empiriques plutôt que par une formule de liaison stéréotypée.
- Réinitialisation des tokens : formuler le raisonnement avec son vocabulaire propre plutôt qu'en ajustant à la marge un paragraphe généré.
L'effet de la traduction linguistique
Google DeepMind relève également que la traduction vers une autre langue constitue une transformation qui dégrade fortement le filigrane. Le modèle traducteur choisissant les mots cibles selon les probabilités de la langue d'arrivée, le filigrane originel se dissipe.
Cependant, traduire puis retraduire un mémoire pour contourner un outil détériore la précision conceptuelle et crée des maladresses syntaxiques immédiatement perceptibles par un jury de soutenance.
Seuils de longueur et contraintes factuelles
DeepMind met en évidence deux cas de figure où SynthID Text est intrinsèquement moins performant :
- Les textes courts : une ou deux phrases ne contiennent pas assez de transitions de tokens pour dégager une certitude statistique solide.
- Les contenus factuels très contraints : pour énoncer un théorème ou une définition juridique stricte, le modèle ne dispose d'aucune marge de liberté lexicale pour biaiser les probabilités sans risquer l'erreur factuelle.
Filigrane de provenance vs détecteurs universitaires (Compilatio, GPTZero)
Il convient de ne pas confondre le filigrane et l'analyse de style :
| Critère | Filigrane SynthID | Logiciels universitaires (Compilatio) |
|---|---|---|
| Principe de contrôle | Clé cryptographique secrète | Perplexité, burstiness et monotonie |
| Périmètre | Modèles compatibles (Gemini) | Tout texte soumis à l'évaluation |
| Effet de la réécriture | Réduit la confiance statistique | Nécessite de varier le rythme et la syntaxe |
Paraphraseurs automatiques vs humanisation académique
Pour des travaux de master ou de doctorat, les paraphraseurs automatiques présentent des risques majeurs :
- Altération des citations d'auteurs et suppression de repères bibliographiques.
- Dégradation des formules mathématiques et des expressions LaTeX.
- Remplacement de la prudence épistémique par un style familier inadapté.
Une réécriture scientifique doit respecter les termes clés du domaine tout en restituant une dynamique rédactionnelle authentique. Pour en savoir plus, consultez notre guide sur le détecteur SynthID pour le texte et notre dossier sur les méthodes pour contourner le filigrane de texte SynthID.
Interpréter les résultats d'analyse avec discernement
À la suite des annonces de Google du 7 octobre 2026, gardez à l'esprit que les technologies de traçabilité ont pour but de certifier la provenance, et non de pénaliser la recherche assistée légitime. Conservez toujours vos historiques de versions, vos notes préparatoires et vos comptes rendus d'encadrement pour attester de la genèse humaine de votre démarche scientifique.
Résultats vérifiés face aux détecteurs pour La paraphrase supprime-t-elle le filigrane SynthID texte ? Réécriture et traduction expliquées
Chaque texte traité avec ThesisHuman s'appuie sur des vérifications reproductibles face aux logiciels d'analyse de texte et aux détecteurs d'IA.
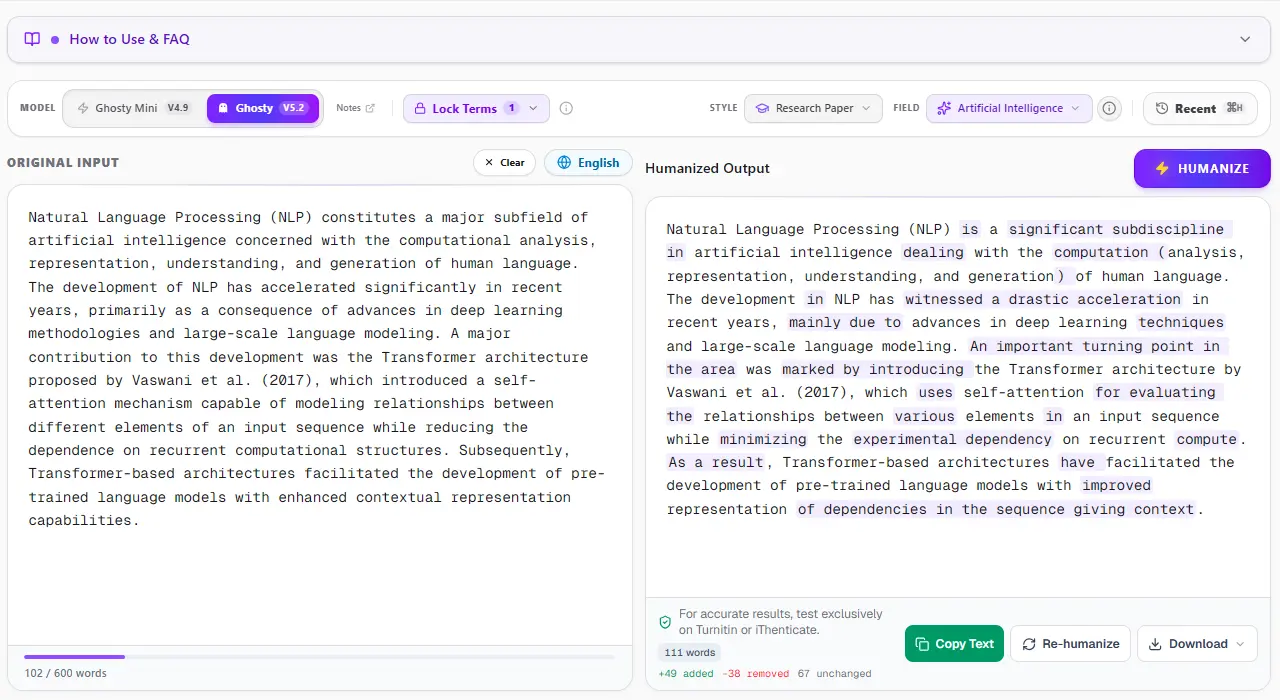
1. Interface ThesisHuman: style, discipline et technologie Term Lock
Contrairement aux paraphraseurs grand public qui remplacent aveuglément les mots par des synonymes approximatifs, ThesisHuman permet de configurer le genre universitaire précis (mémoire de master, thèse de doctorat, article scientifique, revue de littérature) et la discipline concernée (droit, médecine, économie, ingénierie). Grâce à Term Lock, vos citations auteur-date (APA, Harvard), références numériques (Vancouver, IEEE), formules LaTeX et concepts théoriques clés restent rigoureusement intacts pendant le raffinement stylistique.
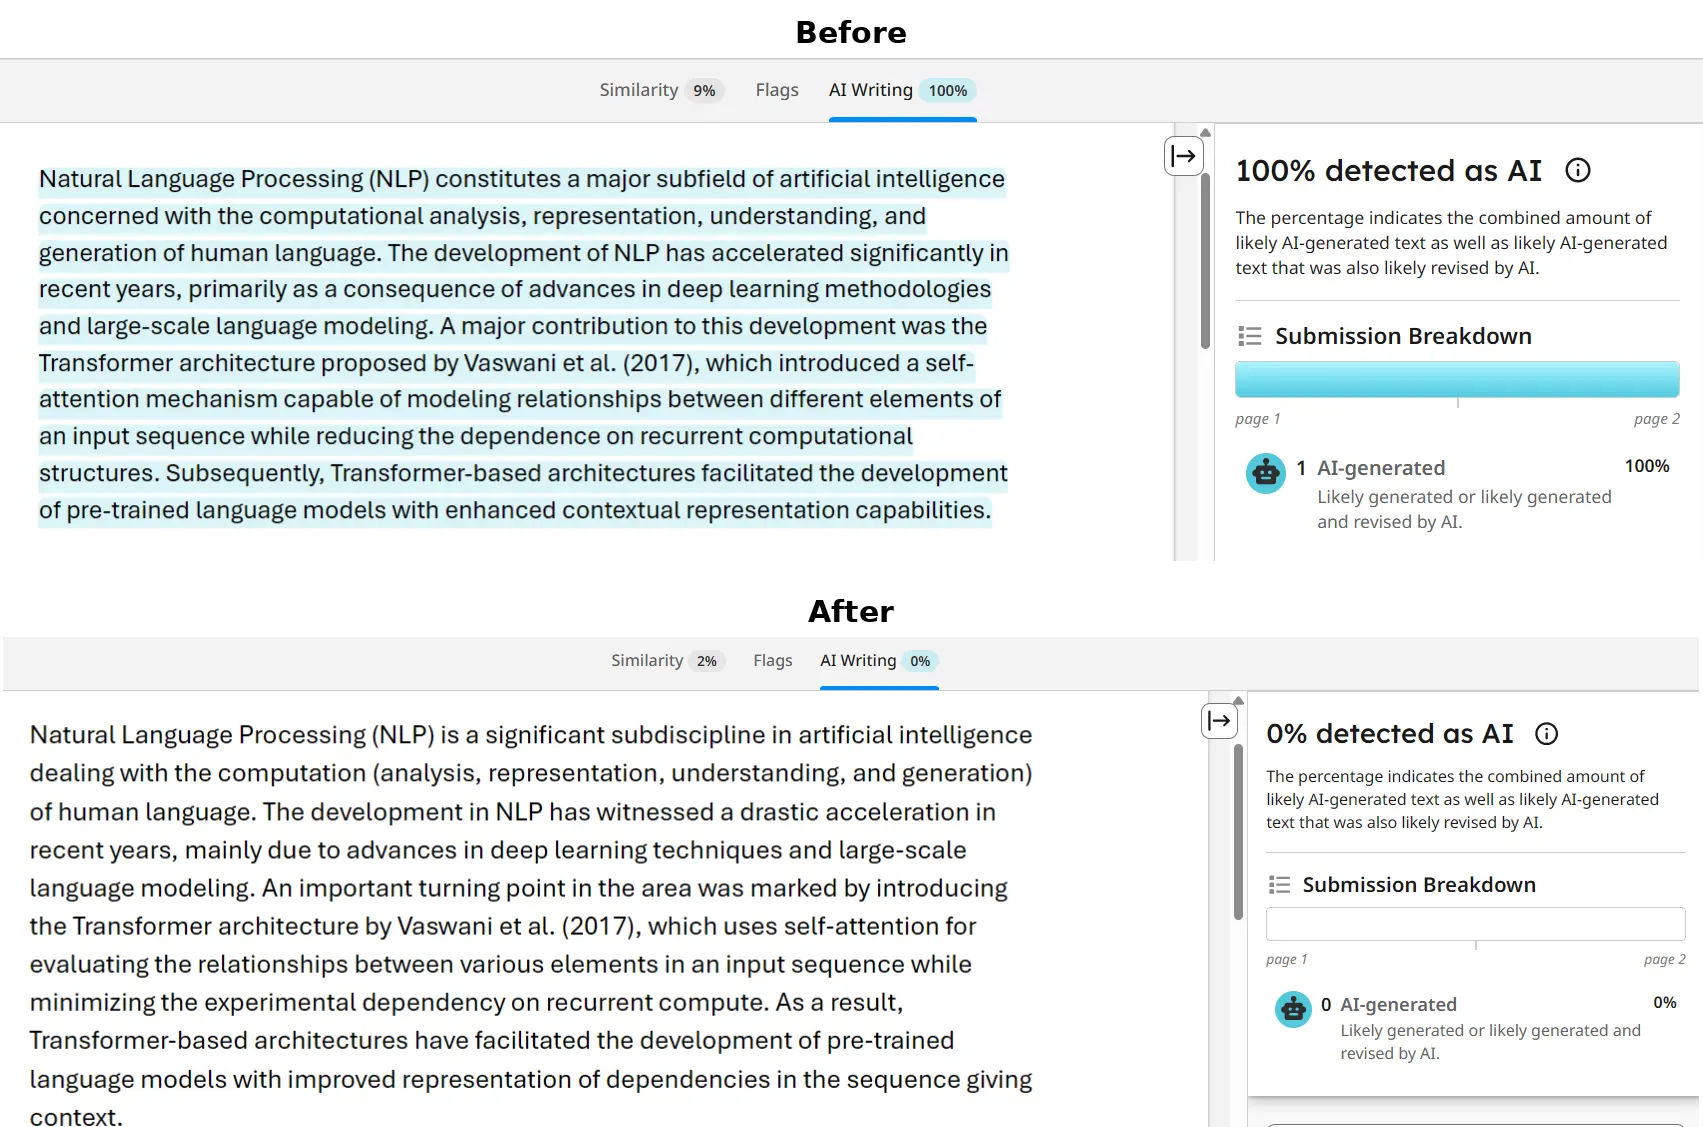
2. Vérification Turnitin et iThenticate: 0% d'indice d'IA
Turnitin et iThenticate examinent les soumissions par segments textuels successifs pour évaluer la régularité mathématique des enchaînements. Un premier jet généré par IA présente une cadence trop prévisible qui alerte les modules de détection. Après passage dans ThesisHuman, la rédaction retrouve l'asymétrie propre à une argumentation personnelle tout en conservant scrupuleusement les références critiques.
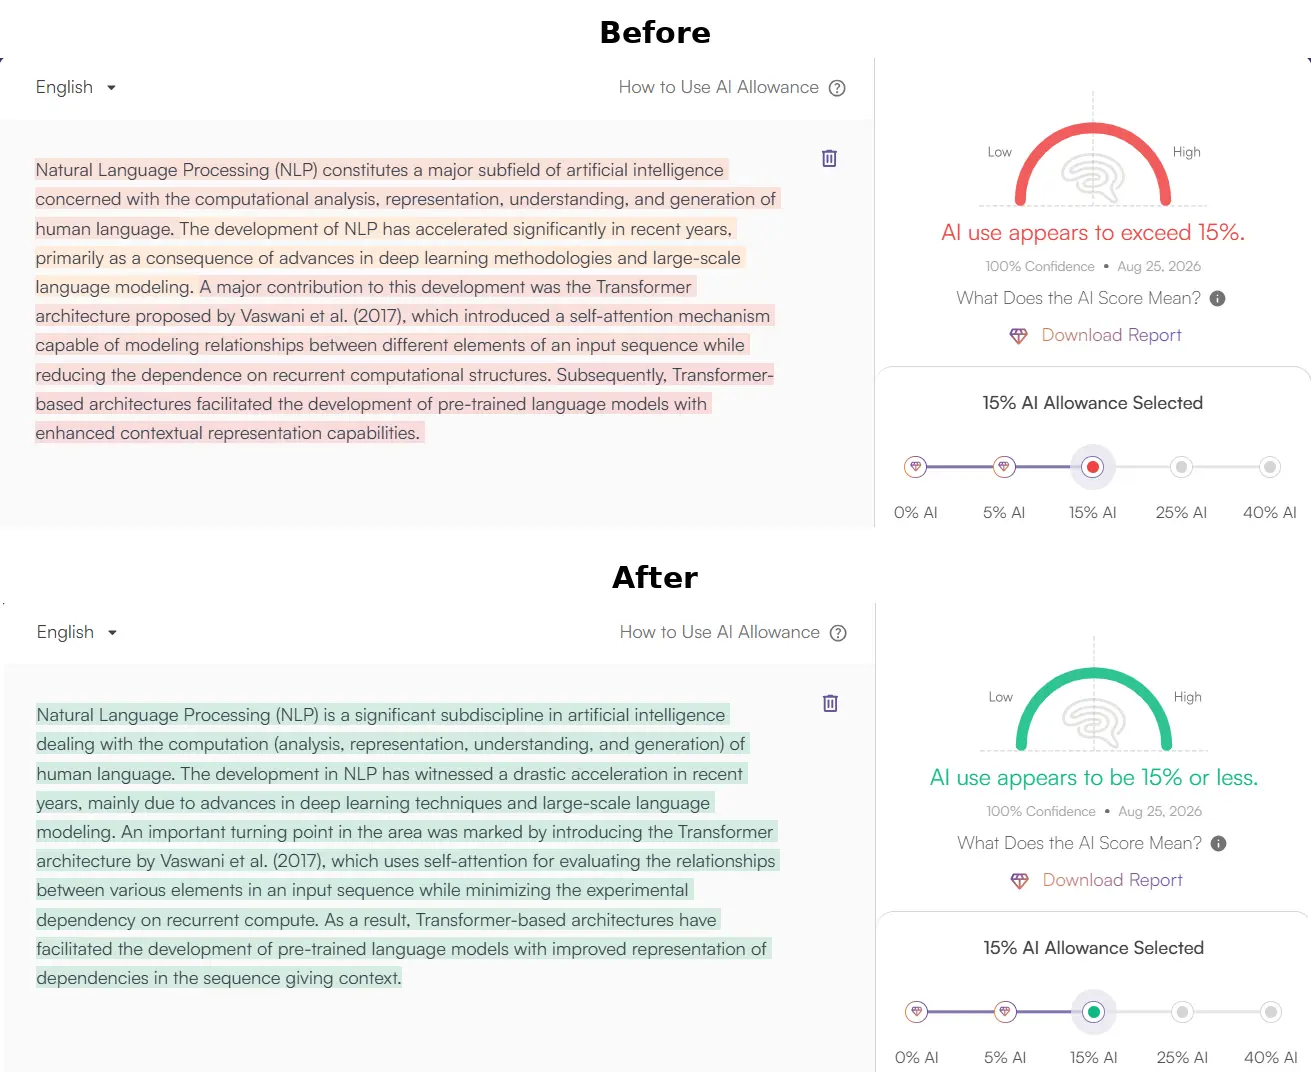
3. Vérification GPTZero: conformité des courbes de perplexité et de cadence
GPTZero évalue le texte en mesurant la perplexité des propositions et l'éclatement syntaxique global (burstiness). Les ébauches brutes des modèles présentent une variance faible d'une phrase à l'autre. ThesisHuman rétablit l'asymétrie naturelle de l'écriture intellectuelle en combinant affirmations directes et périodes subordonnées élaborées.
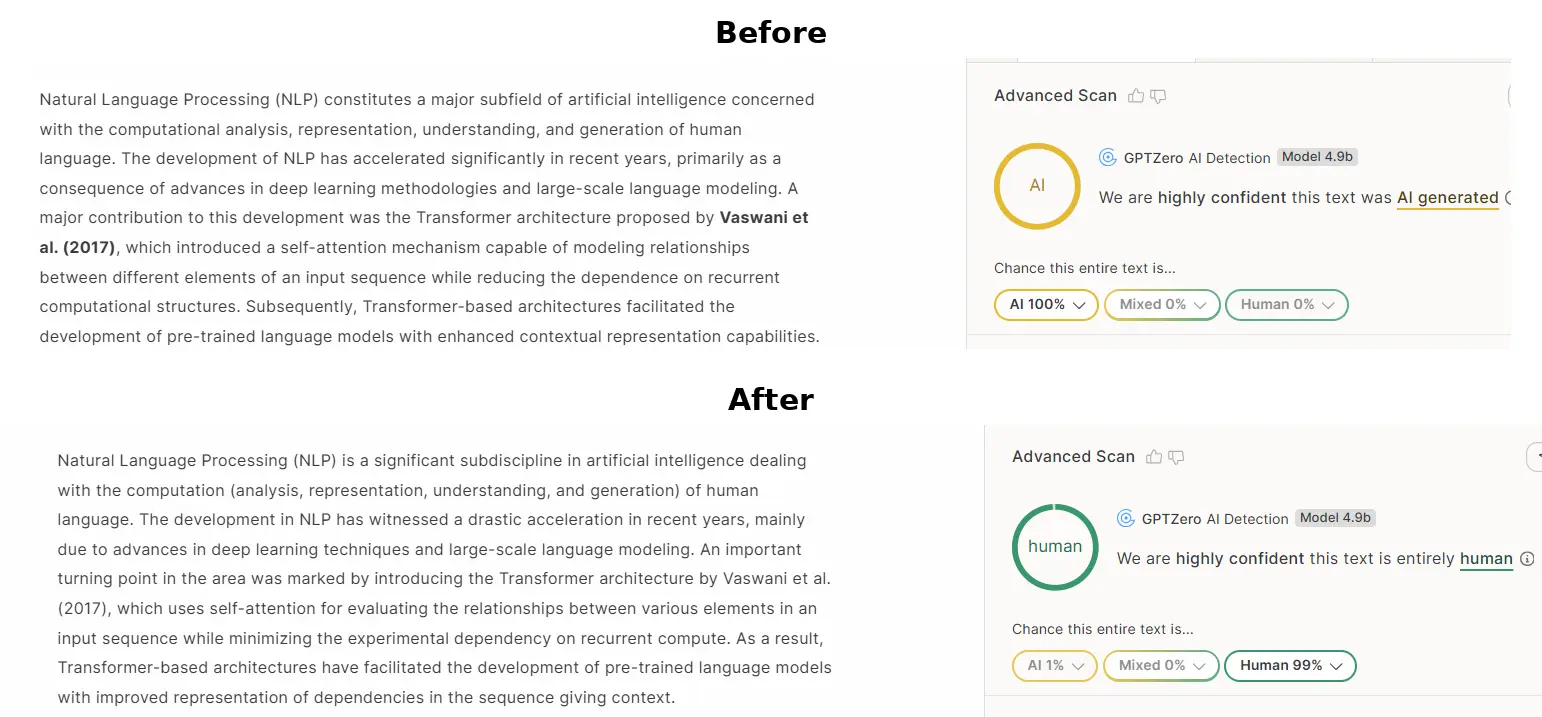
4. Vérification Originality.ai: élimination des n-grammes artificiels
Originality.ai repère les successions prévisibles de n-grammes et les tics de langage récurrents des modèles (tels que 'il convient de souligner', 'un rôle pivot' ou 'témoigne de'). ThesisHuman élimine ces automatismes stylistiques pour renforcer la clarté du propos sans toucher aux équations ni aux citations d'appui.