SynthID Tekstdetector: Kan Google AI-Teksten en ChatGPT-Content Detecteren?
Op 7 oktober 2026 lanceerde Google het openbare SynthID Detector-portaal. Ontdek welke bestanden worden gecontroleerd, hoe SynthID Text werkt en of het ChatGPT herkent.
Op 7 oktober 2026 kondigde Google de wereldwijde openstelling aan van zijn publieke SynthID Detector via synthid.com. Waar het verificatieplatform voorheen beperkt bleef tot geselecteerde onderzoekspartners en journalisten, kan nu iedereen digitale bestanden uploaden om te controleren op watermerken van Google DeepMind. Aan Nederlandse en Vlaamse universiteiten riep het nieuws onmiddellijk vragen op: kan Google nu automatisch essays en thesissen scannen op AI-gebruik, en herkent het systeem ook teksten van ChatGPT?
Voor academici, studenten en docenten is het essentieel om feiten te scheiden van nieuwsberichten. Het uitgebreide publieke portaal en de technologie SynthID Text zijn twee verschillende componenten, en het verifiëren van herkomst verschilt fundamenteel van reguliere AI-detectie.
Wat veranderde er op 7 oktober 2026?
Op 7 oktober 2026 breidde Google zijn verificatie-initiatief uit naar een openbare Engelstalige webomgeving op synthid.com. Gebruikers wereldwijd kunnen nu bestanden analyseren op digitale watermerken die zijn aangebracht door compatibele generatieve modellen.
Tegelijkertijd maakte Google samenwerkingen bekend met industriepartners. De aankondiging van 7 oktober bevestigt dat de huidige openbare SynthID Detector ondersteunde media (afbeeldingen, video en audio) kan verifiëren van Google en partners waaronder OpenAI, NVIDIA en Kakao, met integratie voor Apple binnenkort. Dit toont echter niet aan dat teksten van ChatGPT van een SynthID-watermerk zijn voorzien, en de praktische reikwijdte wordt bepaald door de ondersteunde mediatypes.
Wat controleert de openbare SynthID Detector werkelijk?
Een wijdverbreid misverstand is dat men een geschreven tekst of paper simpelweg kan kopiëren en plakken op synthid.com. Om de werking te begrijpen, moet men eerdere aankondigingen, de actuele modaliteiten van het openbare portaal en de onderliggende technologie onderscheiden.
Toen Google het SynthID Detector-portaal in mei 2025 voor het eerst aankondigde, beschreef de vroege documentatie de mogelijkheid om afbeeldingen, audiotracks, video's of tekstfragmenten te scannen die zijn gemaakt met ondersteunde Google AI-tools. De publieke ervaring die op 7 oktober 2026 werd gelanceerd, biedt momenteel verificatie voor afbeeldingen, video en audio:
- Afbeeldingen: Visuele bestanden gegenereerd met Google Imagen en compatibele partnermodellen.
- Video: Synthetische videoclips afkomstig van modellen zoals Google Veo.
- Audio: Muziekcomposities en spraaksynthese gegenereerd door architecturen zoals Lyria.
De huidige publieke ervaring van de SynthID Detector, aangekondigd op 7 oktober 2026, biedt verificatie voor afbeeldingen, video en audio. Dit betekent niet dat SynthID Text niet meer bestaat, en eerdere documentatie van de Detector beschreef eveneens mogelijkheden voor het scannen van tekst. SynthID Text blijft een reële onderliggende watermerk- en identificatietechnologie voor ondersteunde Gemini-tekst.
Hoe werkt SynthID Text volgens Google DeepMind?
Waar bij afbeeldingen pixelwaarden onzichtbaar worden aangepast, bestaat platte tekst uit afzonderlijke tekens. Verborgen metadata in een tekstdocument overleeft kopiëren en plakken naar een andere tekstverwerker niet.
Volgens de wetenschappelijke publicaties van Google DeepMind (waaronder het onderzoek in Nature uit 2024) grijpt SynthID Text in tijdens de probabilistische woordkeuze:
- Kansverdeling: Bij elk nieuw token berekent het taalmodel de waarschijnlijkheid van alle mogelijke volgende woorden.
- Pseudotoevallige modulatie: SynthID stuurt deze kansen op basis van een geheime sleutel minimaal bij in het voordeel van specifieke tokens.
- Natuurlijke stijl: De kwaliteitsverandering is zo minuscuul dat syntaxis, vaktermen en betekenis voor menselijke lezers volkomen authentiek blijven.
- Statistische verificatie: Bij het analyseren toetst het detectiemodel de woordpatronen aan de geheime sleutel. Over langere teksten levert de gecumuleerde kansafwijking wiskundig bewijs op van herkomst.
Herkent de SynthID Detector teksten van ChatGPT?
Het duidelijke antwoord is: nee. Standaardteksten die worden gegenereerd door ChatGPT (OpenAI) dragen geen SynthID-watermerk van Google, en de SynthID Detector herkent geen teksten van ChatGPT.
Hoewel OpenAI eigen methoden voor tekstwatermerken onderzoekt, bestaat gewone ChatGPT-uitvoer uit standaard Unicode zonder de DeepMind-sleutel. De aankondiging van 7 oktober 2026 bevestigt dat de openbare SynthID Detector ondersteunde afbeeldings-, video- en audiomedia kan verifiëren van Google en partners waaronder OpenAI, NVIDIA en Kakao (met Apple binnenkort). Dit toont geenszins aan dat teksten van ChatGPT een SynthID-watermerk dragen.
De partnerschappen met OpenAI, NVIDIA en Kakao: de feiten
De aankondiging van 7 oktober bevestigt dat de huidige openbare SynthID Detector ondersteunde afbeeldings-, video- en audiomedia van Google en partners zoals OpenAI, NVIDIA en Kakao kan verifiëren, met Apple binnenkort. Wat tonen de officiële feiten aan?
| Organisatie | Bevestigde Reikwijdte in Aankondiging | Toont dit een watermerk in ChatGPT-tekst aan? |
|---|---|---|
| Google DeepMind | Imagen, Veo, Lyria en Gemini Text | Ja, in compatibele Gemini-omgevingen |
| OpenAI | Verificatie van ondersteunde media in Detector | Nee, toont niet aan dat ChatGPT-tekst een SynthID-watermerk heeft |
| NVIDIA | Verificatie van ondersteunde partnermedia | Nee, toont geen tekstwatermerken aan |
| Kakao & Apple | Partnermedia-integratie (Apple binnenkort) | Nee, toont geen tekstwatermerken aan |
De aankondiging van 7 oktober bevestigt dat de huidige openbare SynthID Detector ondersteunde afbeeldings-, video- en audiomedia kan verifiëren van Google en partners waaronder OpenAI, NVIDIA en Kakao, met Apple op komst. Dit toont belangrijke sectorbrede afstemming voor synthetische media aan, maar bewijst niet dat teksten van ChatGPT van een SynthID-watermerk zijn voorzien.
Watermerkverificatie vs. statistische AI-detectoren (Turnitin, Copyleaks)
Het is van essentieel belang om de twee methoden uit elkaar te houden:
- Statistische AI-detectoren (Turnitin, Copyleaks, GPTZero): Meten zinslengte, uniformiteit en woordvoorspelbaarheid. Ze proberen te raden of een stijl kunstmatig aandoet, wat bij formele academische teksten dikwijls leidt tot valse beschuldigingen.
- Herkomstverificatie (SynthID): Zoekt naar een concrete wiskundige vingerafdruk. Ontbreekt deze sleutel, dan doet het systeem geen uitspraak over menselijke of machinale creatie.
Hoe bewerkingen de betrouwbaarheid van het watermerk beïnvloeden
Google DeepMind heeft de veerkracht van SynthID Text wetenschappelijk getoetst:
- Inkortingen en kleine wijzigingen: Het watermerk blijft detecteerbaar na het verwijderen van zinnen of het wijzigen van enkele losse woorden.
- Oppervlakkig parafraseren: Het automatisch vervangen van afzonderlijke synoniemen laat de bredere tokenpatronen intact.
- Grondig herschrijven en vertalen: Google stelt expliciet dat de detectiebetrouwbaarheid sterk kan afnemen wanneer de tekst ingrijpend wordt herschreven of vertaald naar een andere taal.
- Korte of feitelijke teksten: Bij formules, wiskundige definities of gestandaardiseerde citaten heeft het model weinig taalkundige vrijheid, waardoor watermerken niet betrouwbaar kunnen worden ingebed.
Praktische gevolgen voor studenten en academische onderzoekers
Voor wie academische artikelen of scripties opstelt in het Nederlands of Engels, brengt de lancering van synthid.com geen automatische tekstopsporing met zich mee. Universiteiten blijven primair werken met traditionele stijldetectoren.
Voor een diepere verkenning van teksttransformaties, lees ons artikel over het omzeilen van het SynthID tekst-watermerk en onze technische analyse over de vraag of parafraseren het SynthID-watermerk verwijdert.
Indien u concepten in het Engels verfijnt voor internationale publicaties, helpt ThesisHuman om de academische cadans te vermenselijken met behoud van wetenschappelijke terminologie en bibliografische referenties.
Geverifieerde resultaten bij detectiesoftware voor SynthID Tekstdetector: Kan Google AI-Teksten en ChatGPT-Content Detecteren?
Elke tekstpassage die met ThesisHuman wordt verwerkt, steunt op reproduceerbare controles bij toonaangevende AI-detectoren en universitaire integriteitssystemen.
1. ThesisHuman Editor: schrijfstijl, vakgebied en Term Lock technologie
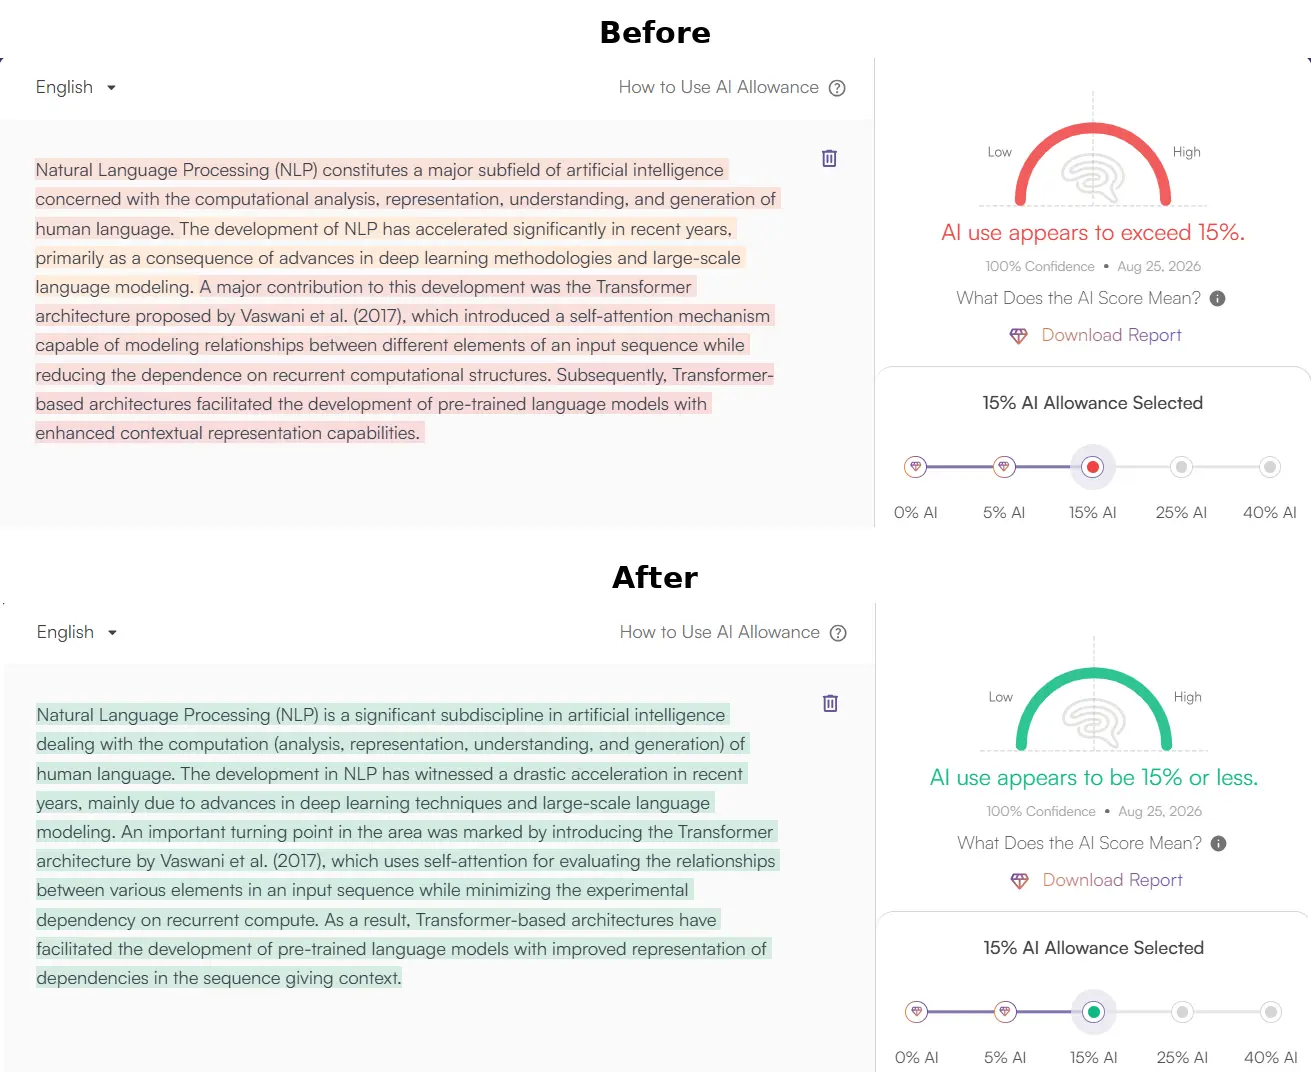
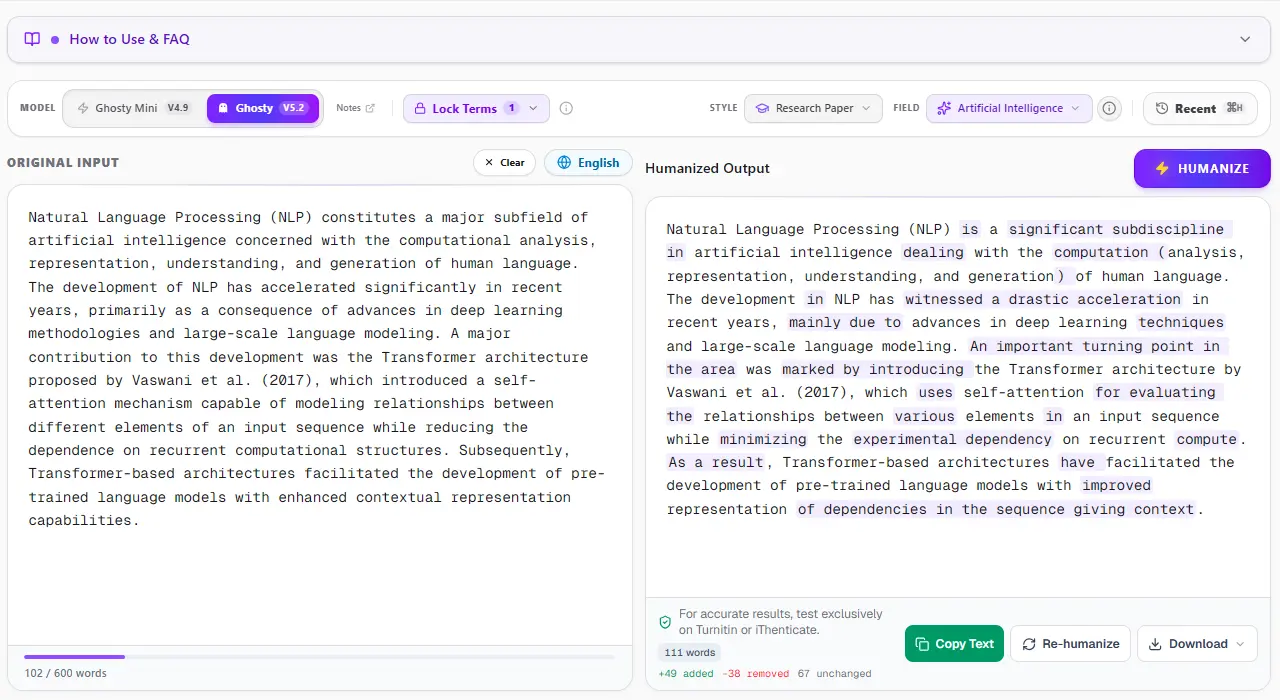
In tegenstelling tot standaard paraphrasers die losse woorden vervangen door willekeurige synoniemen, stelt ThesisHuman je in staat om het exacte academische teksttype (bachelorscriptie, masterproef, onderzoeksvoorstel, wetenschappelijk artikel) en je vakgebied te selecteren. Dankzij Term Lock blijven auteur-jaarcitaten (APA, Harvard), numerieke verwijzingen (Vancouver, IEEE), LaTeX-formules en vaktermen volledig behouden tijdens de stilistische bewerking.
2. Turnitin en iThenticate controle: 0% AI-indicator
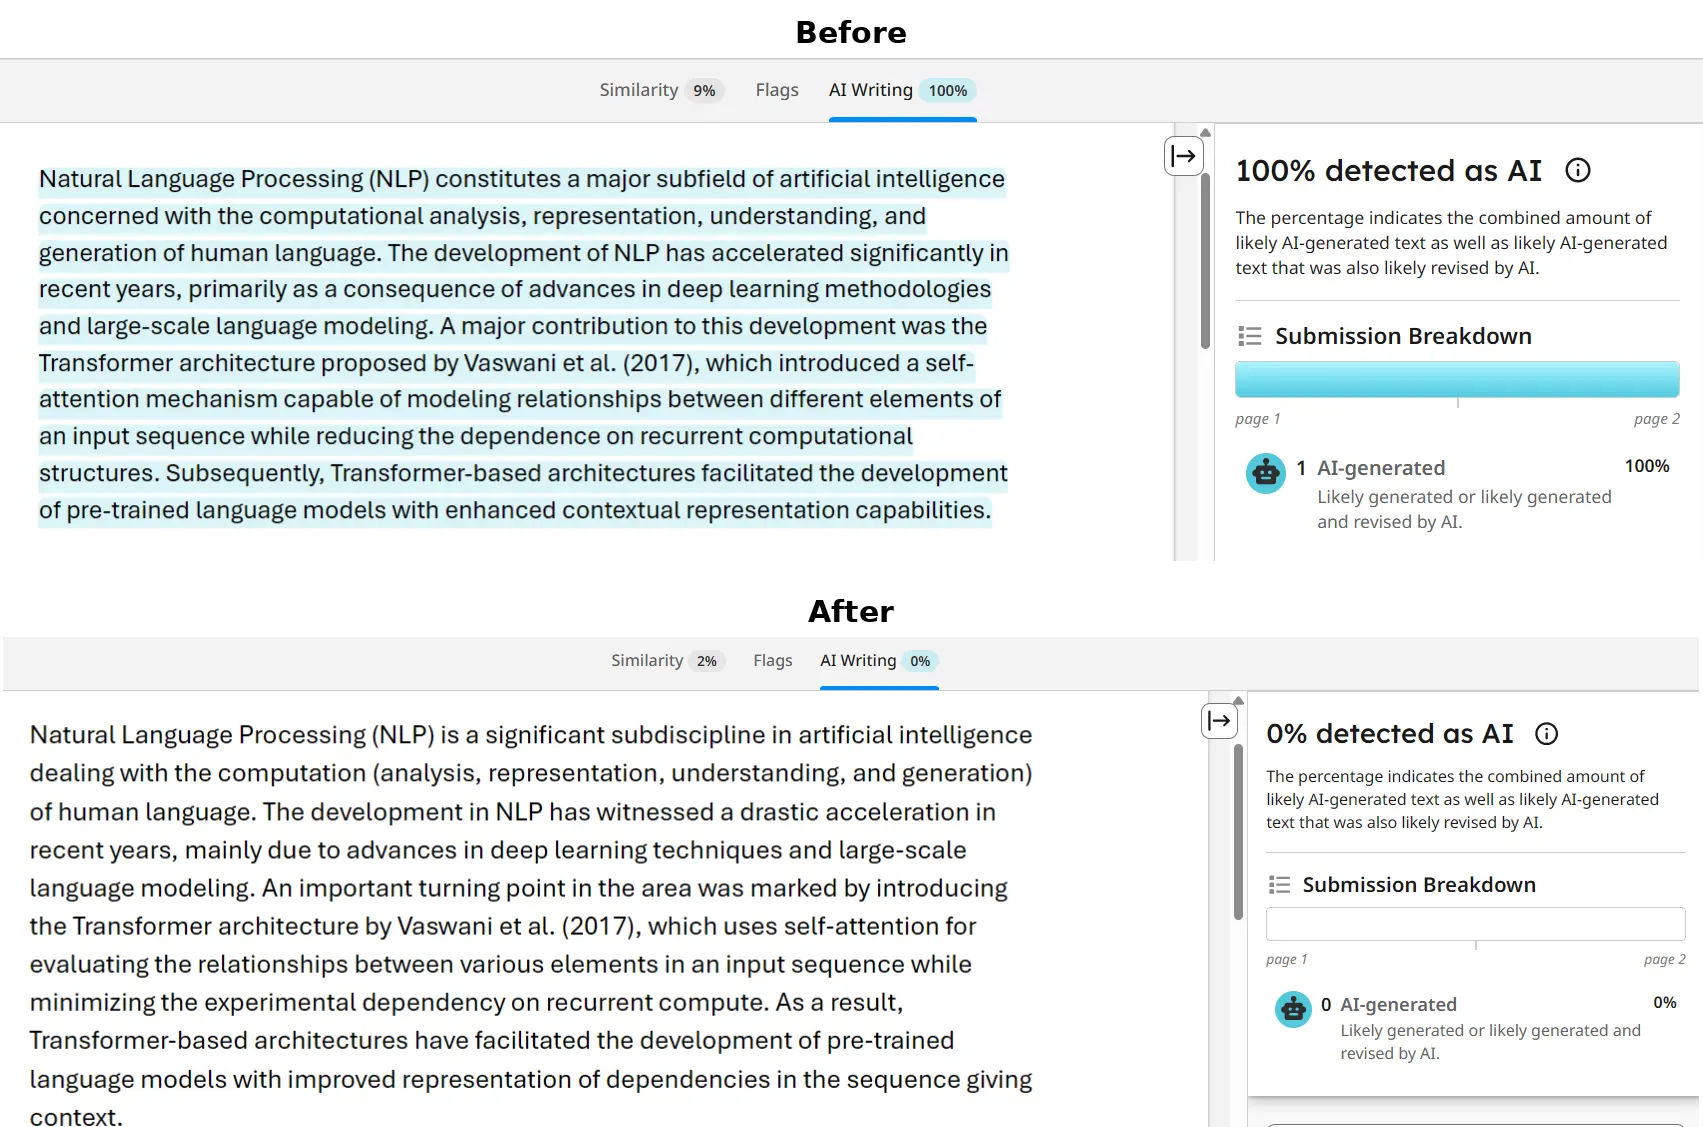
Systemen zoals Turnitin en iThenticate analyseren ingediende documenten in samenhangende tekstblokken om de wiskundige voorspelbaarheid van zinswendingen te berekenen. Onbewerkte AI-concepten vertonen vaak een monotone zinslengte die leidt tot valse meldingen. Na bewerking met ThesisHuman ontstaat een gevarieerde academische cadans waarin alle bronnen en formules accuraat beschermd blijven.
3. GPTZero verificatie: natuurlijke perplexiteit en burstiness
GPTZero beoordeelt teksten door de perplexiteitscurve en de spreiding in zinslengte (burstiness) in kaart te brengen. Ruwe AI-teksten hebben een lage spreiding tussen opeenvolgende zinnen. ThesisHuman herstelt de natuurlijke asymmetrie van wetenschappelijke proza door bondige premissen af te wisselen met complexe, onderbouwde analyses.
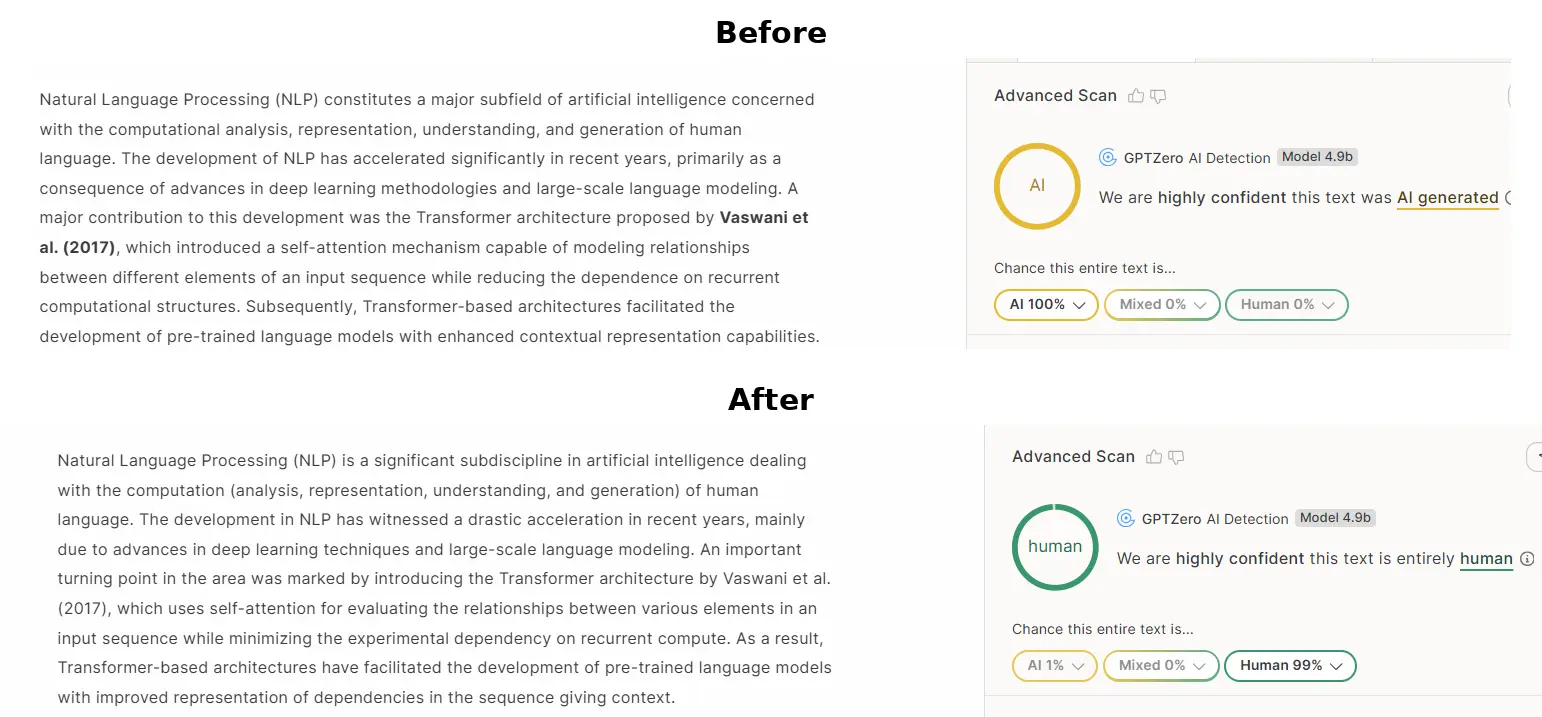
4. Originality.ai verificatie: eliminatie van voorspelbare n-grammen
Originality.ai speurt naar voorspelbare n-gramreeksen en typische stopwoorden van taalmodellen (zoals 'het is cruciaal om te benadrukken' of 'speelt een fundamentele rol'). ThesisHuman saneert deze kunstmatige formules en verhoogt de zeggingskracht, zonder formules of bronvermeldingen te wijzigen.