Verwijdert Parafraseren het SynthID Tekst-Watermerk? Herschrijven, Vertaling en Humanizers Uitgelegd
Verwijdert parafraseren het SynthID Text-watermerk van Google DeepMind? We analyseren de verschillen tussen synoniemen, diep herschrijven en vertaling.
Na de publieke introductie van het SynthID Detector portaal op 7 oktober 2026 is de vraag die academici en schrijvers het meest bezighoudt: verwijdert parafraseren het SynthID-watermerk uit een tekst? Blijft de statistische signatuur van DeepMind traceerbaar wanneer een concept uit Google Gemini door een parafraseertool wordt gehaald?
Om hier een wetenschappelijk onderbouwd antwoord op te geven, moeten we analyseren hoe verschillende gradaties van tekstuele bewerking interageren met het probabilistische model van Google DeepMind.
Wat bedoelt Google met licht parafraseren?
In de technische publicaties van Google DeepMind wordt een duidelijk onderscheid gemaakt tussen oppervlakkige wijzigingen en structurele transformaties. Licht parafraseren behelst het vervangen van enkele woorden door alledaagse synoniemen zonder de zinsstructuur aan te tasten.
Doordat SynthID de cumulatieve kansverdeling over een langere tekstpassage meet, verandert het aanpassen van een handvol woorden nauwelijks iets aan de statistische herkenbaarheid.
Waarom kleine wijzigingen het statistische signaal behouden
Het watermerk van SynthID Text berust niet op een vaste tekenreeks, maar op minieme voorkeuren in de tokenverdeling. Voor een grondige uitleg verwijzen we naar onze gids over de SynthID tekstdetector.
Bij beperkte bewerkingen blijft het merendeel van de tokens overeenkomen met de voorkeuren van de geheime DeepMind-sleutel, waardoor de detector een hoge mate van zekerheid behoudt.
Synoniemen vervangen versus diepe zinsherstructurering
De impact verschilt sterk per type tekstinterventie:
| Type Bewerking | Taalkundige Impact | Effect op SynthID Betrouwbaarheid |
|---|---|---|
| Eenvoudige synoniemvervanging | Vervangen van losse woorden | Robuust: watermerk blijft meetbaar |
| Omkering van zinsdelen | Aanpassing van bijzinsvolgorde | Matige daling in signaalkracht |
| Grondige inhoudelijke herformulering | Volledig nieuwe opbouw van argumenten | Sterke daling vastgesteld door Google |
| Vertaling naar andere taal | Grammaticale en lexicale heropbouw | Significante degradatie van het signaal |
Bevindingen van Google DeepMind over grondig herschrijven
In hun evaluaties erkennen de onderzoekers van Google DeepMind dat de traceerbaarheid sterk afneemt wanneer een tekst substantieel wordt herschreven. Door zinnen opnieuw op te bouwen, verdwijnen de oorspronkelijke tokensequenties en ontbreekt de statistische samenhang met de sleutel.
Voor een analyse van gangbare omzeilingsmethoden, lees ons overzicht over het omzeilen van het SynthID tekst-watermerk.
Vertaling als diepgaande structurele teksttransformatie
Bij het vertalen naar een andere taal worden zinsconstructies en woordkeuzes opnieuw geordend volgens de regels van de doeltaal. Dit proces verbreekt de probabilistische verbindingen uit de brontaal, waardoor het watermerk nauwelijks nog traceerbaar is.
Watermerkbetrouwbaarheid vs. statistische AI-detectiescores
Schrijvers moeten watermerkbetrouwbaarheid niet verwarren met de scores van systemen zoals Turnitin of Copyleaks. Zelfs als een herkomstwatermerk vervaagt, kan een tekst door stijldetectoren als machinaal worden bestempeld als het ritme repetitief en voorspelbaar blijft.
De invloed van tekstlengte en inhoudelijke restricties
De werking van SynthID Text hangt af van twee doorslaggevende randvoorwaarden:
- Lengte van de tekst: Korte fragmenten leveren onvoldoende data om de wiskundige toetsingsdrempel te overschrijden.
- Taalkundige vrijheid: Bij strikt feitelijke onderwerpen, zoals wiskundige formules of scheikundige benamingen, kan het model nauwelijks alternatieve woorden kiezen zonder aan accuratesse in te boeten.
Korte feitelijke antwoorden versus uitgebreide papers
Waar een theoretisch betoog volop variatiemogelijkheden biedt om een watermerk in te weven, biedt een feitelijk antwoord vrijwel geen speelruimte, wat resulteert in een zwak of niet-detecteerbaar watermerk vanaf het begin.
Manuele redactie, generieke tools en academische humanizers
Onderzoekers die werken met vroege concepten hebben drie opties:
- Generieke parafraseertools: Vervangen willekeurig woorden, wat dikwijls leidt tot vaktermen die inhoudelijk niet meer kloppen.
- Volledig handmatige herschrijving: De meest zekere route, maar uiterst tijdrovend.
- Academische humanizers: Oplossingen zoals ThesisHuman verbeteren het zinsverloop en de natuurlijke cadans van Engelstalige academische concepten, met behoud van formules, cijfers en citaten via termvergrendeling.
Hoe verificatierapporten verantwoord te interpreteren
Ieder controlerapport dient kritisch te worden benaderd. Het al dan niet aanwezig zijn van een digitaal watermerk zegt niets over de wetenschappelijke diepgang of de inhoudelijke waarde van het onderzoek.
Geverifieerde resultaten bij detectiesoftware voor Verwijdert Parafraseren het SynthID Tekst-Watermerk? Herschrijven, Vertaling en Humanizers Uitgelegd
Elke tekstpassage die met ThesisHuman wordt verwerkt, steunt op reproduceerbare controles bij toonaangevende AI-detectoren en universitaire integriteitssystemen.
1. ThesisHuman Editor: schrijfstijl, vakgebied en Term Lock technologie
In tegenstelling tot standaard paraphrasers die losse woorden vervangen door willekeurige synoniemen, stelt ThesisHuman je in staat om het exacte academische teksttype (bachelorscriptie, masterproef, onderzoeksvoorstel, wetenschappelijk artikel) en je vakgebied te selecteren. Dankzij Term Lock blijven auteur-jaarcitaten (APA, Harvard), numerieke verwijzingen (Vancouver, IEEE), LaTeX-formules en vaktermen volledig behouden tijdens de stilistische bewerking.
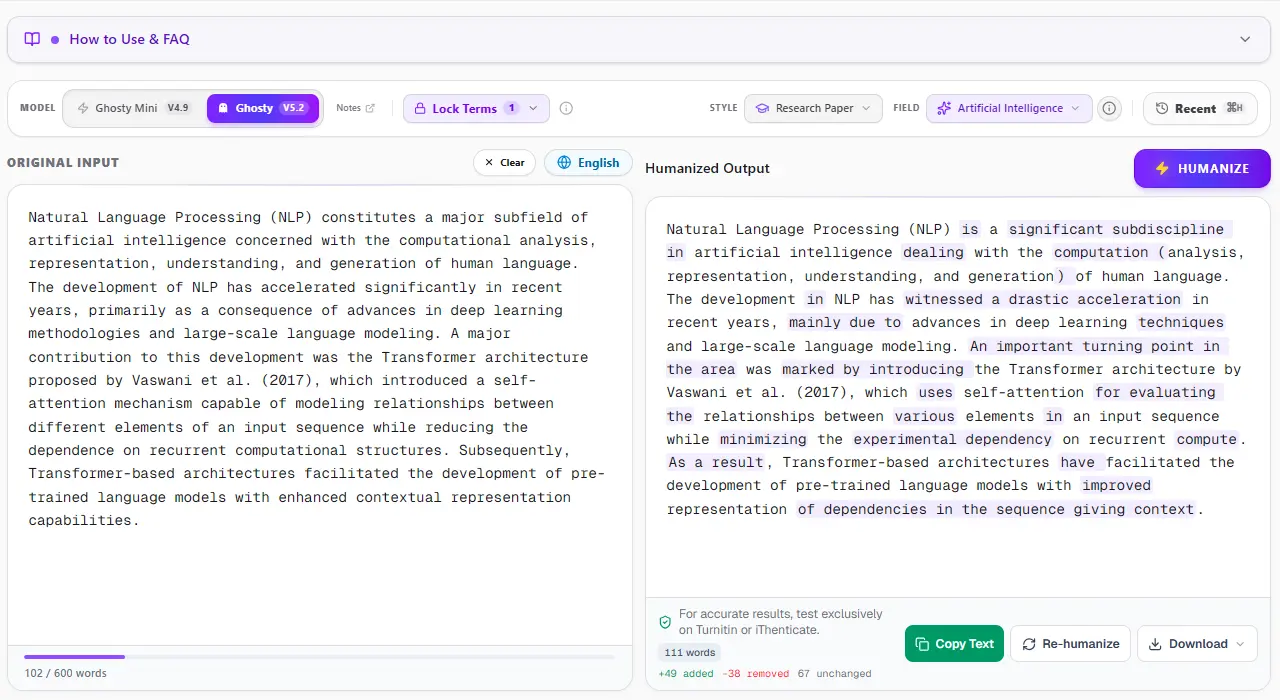
2. Turnitin en iThenticate controle: 0% AI-indicator
Systemen zoals Turnitin en iThenticate analyseren ingediende documenten in samenhangende tekstblokken om de wiskundige voorspelbaarheid van zinswendingen te berekenen. Onbewerkte AI-concepten vertonen vaak een monotone zinslengte die leidt tot valse meldingen. Na bewerking met ThesisHuman ontstaat een gevarieerde academische cadans waarin alle bronnen en formules accuraat beschermd blijven.
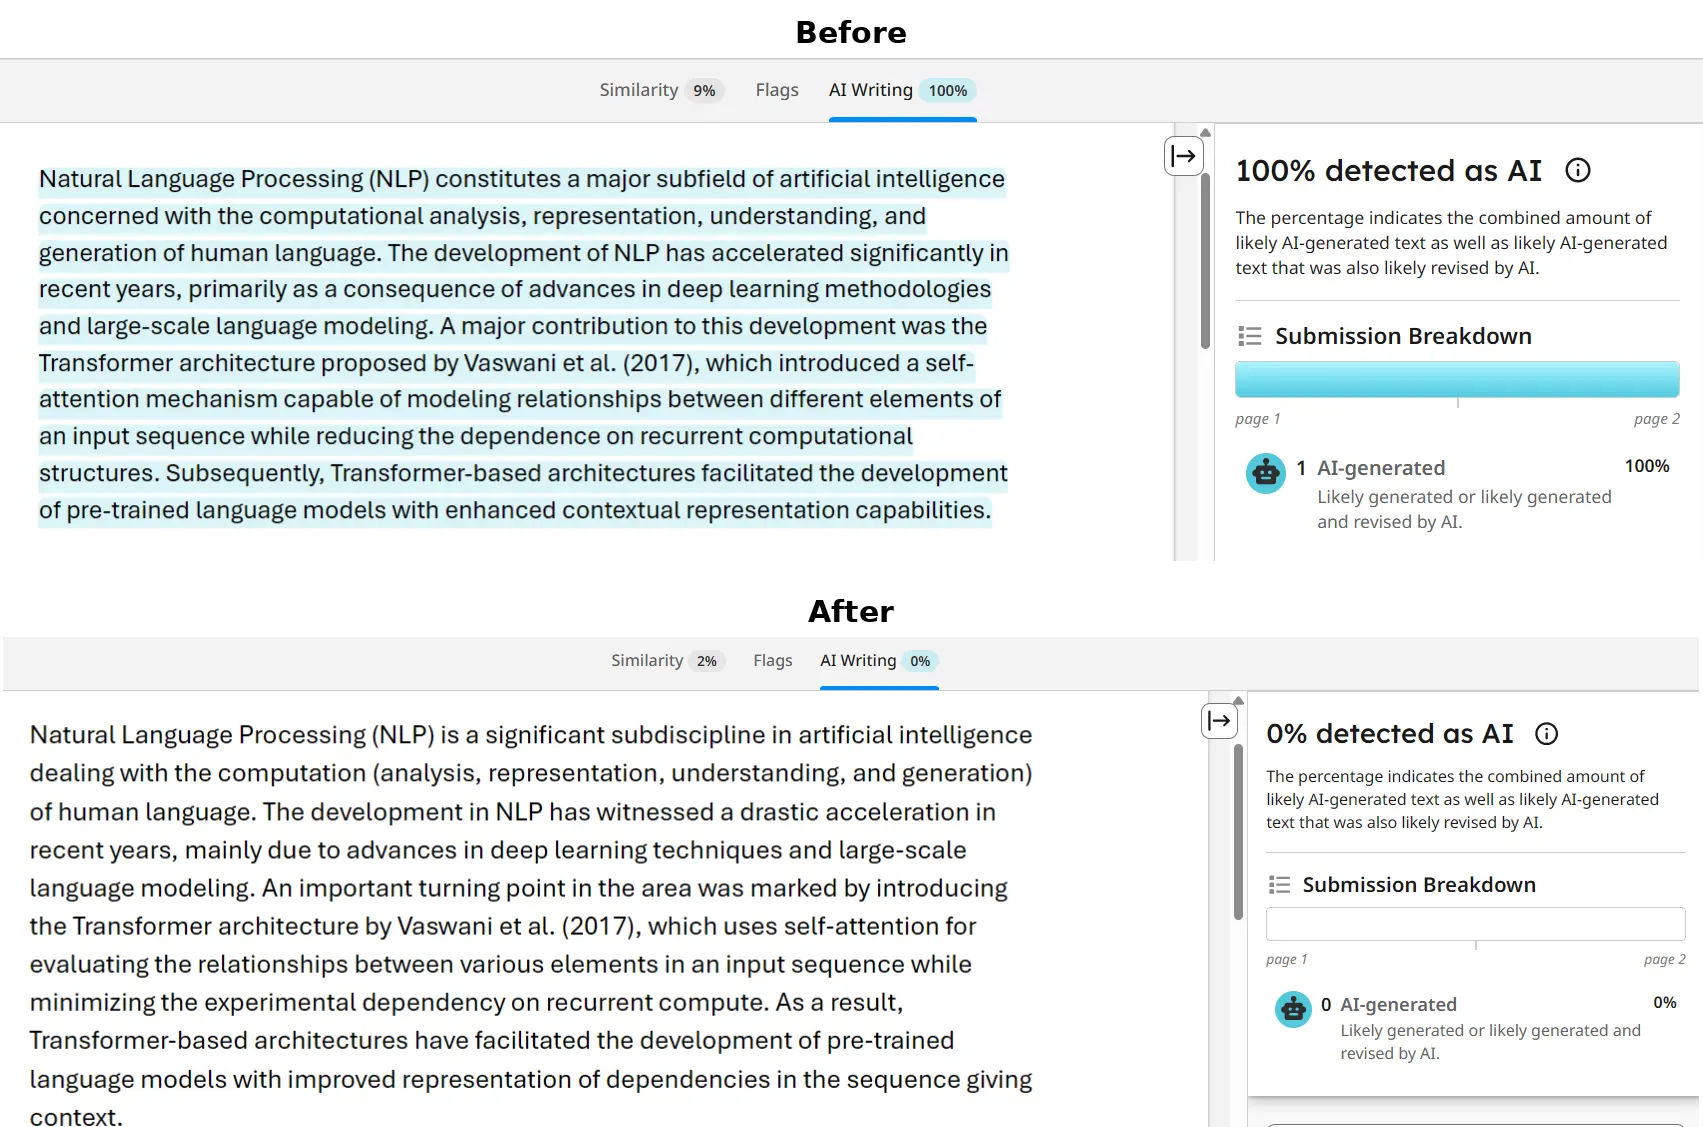
3. GPTZero verificatie: natuurlijke perplexiteit en burstiness
GPTZero beoordeelt teksten door de perplexiteitscurve en de spreiding in zinslengte (burstiness) in kaart te brengen. Ruwe AI-teksten hebben een lage spreiding tussen opeenvolgende zinnen. ThesisHuman herstelt de natuurlijke asymmetrie van wetenschappelijke proza door bondige premissen af te wisselen met complexe, onderbouwde analyses.
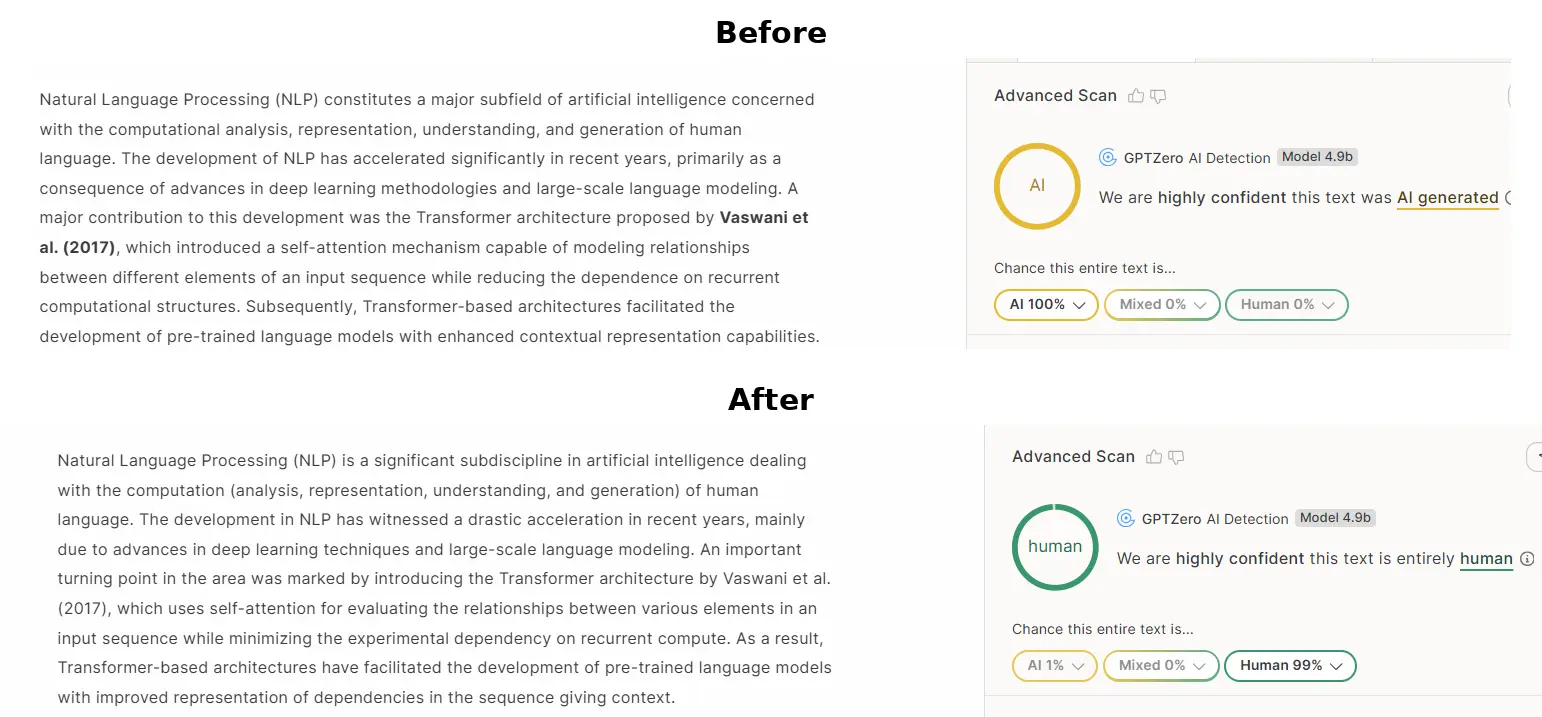
4. Originality.ai verificatie: eliminatie van voorspelbare n-grammen
Originality.ai speurt naar voorspelbare n-gramreeksen en typische stopwoorden van taalmodellen (zoals 'het is cruciaal om te benadrukken' of 'speelt een fundamentele rol'). ThesisHuman saneert deze kunstmatige formules en verhoogt de zeggingskracht, zonder formules of bronvermeldingen te wijzigen.